ADKで進める中小企業の業務・インフラ自動化第5回 / 全11回
インフラ担当者の朝を変える:ADKで監視と日次点検を整理する
Google ADKで監視情報と日次点検を整理する設計を、従業員35人の架空企業を例に解説します。受注業務のSLI、事実と仮説の区別、権限、通知優先度、担当者への引き継ぎを具体化。公開されたGoogle SREの活用例と独自の設計提案を分け、評価方法と四週間の進め方、実践シートを紹介します。

この記事の内容
この記事でわかること
朝の点検を、受注と倉庫の判断へ結び付ける。
数値の検証と、AIの仮説を分けて報告する。
優先度・担当・期限・受領まで記録する。
連載第5回|AIの業務自動化を、毎朝の点検から育てる。技術情報の確認基準日:2026年10月14日。
朝一番に監視画面を開く。昨晩のバックアップを確認する。問い合わせに「遅い」という言葉があればログを探す。クラウドの請求予測を見て、昨日の変更を思い出す。中小企業のインフラ担当者は、こうした確認を、端末の設定や社内の問い合わせと並行して進めています。画面を一巡した時点で午前中が終わることもあるでしょう。
この仕事には、状況を見て責任を持つ判断と、同じ場所から情報を集めて並べる作業が混ざっています。後者を整えると、担当者は「本当に調べるべきこと」に時間を使いやすくなります。GoogleのAgent Development Kit、ADKは、その情報収集と説明をつなぐ土台の候補になります。
本記事では、毎朝の点検を、根拠と担当者が見える一枚の報告にする設計を扱います。受注サービスを運営する架空の設備・部品販売会社「ケース企業A」を例に、何を測り、何をAIに読ませ、異常時に誰へ渡すかまで考えます。本文の会社、数字、手順は説明用の仮想設計です。導入済みの顧客事例や達成済みの効果として示すものではありません。
1. Google SREの活用例から学ぶ範囲
Googleは2026年5月、SREのAIプログラムの開発基盤としてADKを挙げ、運用手順、障害調査、連絡をエージェントが支援すると公表しました。個々の機能がどのフレームワークを使うか、ADK単体でどれだけ効果が出たかまでは示していません。Googleの公表資料
ここから取り入れたいのは、運用情報を利用可能な形にして担当者を支える考え方です。Googleの組織規模や運用体制をそのまま再現する必要はありません。社内の一つのサービスについて、毎朝確認する項目と異常時の窓口を決めるところから始められます。
企業が公表した運用例、公式の実装サンプル、自社向けの設計案は、根拠の種類が異なります。ADKのコードを動かせた段階では、実際の受注サービスを安全に管理できるかは別途確認が必要です。本記事の構成は、この活用例から考えた中小企業向けの提案です。
2. 最初に「朝、どの判断が必要か」を決める
ケース企業Aは従業員35人という設定です。取引先が受注ポータルで注文を入力し、倉庫へデータを渡します。社内ITとインフラを兼任する担当者は一人で、営業責任者が受注業務の判断を、外部の保守会社がアプリケーション調査を担います。担当者が休む日も、注文は止まりません。
この会社の朝の判断を、次の三つに絞ります。
- 取引先は注文を受け付けてもらえる状態か。
- 受付済みの注文は、必要な時刻までに倉庫へ渡っているか。
- 担当者が本日対応すべきリスクや未完了の作業はあるか。
CPUやメモリーを一覧にするだけでは、この三つに答えられません。受注の成功、連携の遅れ、復旧手順の確認などを、業務の意味と結び付けます。目的を先に決めると、AIが読むデータも減らせます。
たとえばバックアップの点検は、最終ジョブの成功表示に加え、どのデータが対象か、いつまでのデータを保存したか、復元確認を最後に行ったのはいつか、担当者が判断できる情報をそろえます。復元試験を実施していないなら、その事実を未確認として残します。報告を詳しくすることと、確認作業を実施したことを同一視しません。
3. SREの考え方を、少人数の点検に置き換える
SREでは、手作業で繰り返され、持続的な価値を生まず、サービスの成長とともに増える運用作業をtoilと呼びます。毎日の確認でも、改善につながる分析と、同じ情報を転記する作業では性質が違います。Google SRE:Eliminating Toil
架空の会社では、過去の一週間を振り返り、「毎日同じ順番で確認したもの」「情報を探したために遅れたもの」「人の判断が必要だったもの」を記録します。その上で点検の入口を整理します。
点検対象: 受注受付
確認したいこと: 利用者の注文が受付完了になるか
根拠となる情報: 入口の依頼数、受付結果、受付番号
点検対象: 倉庫連携
確認したいこと: 未処理の注文が滞留していないか
根拠となる情報: 連携台帳、処理時刻、失敗の種別
点検対象: バックアップ
確認したいこと: 保存範囲と復元の確認がそろうか
根拠となる情報: ジョブ結果、保存時刻、復元試験記録
点検対象: 証明書などの期限
確認したいこと: 更新の担当と予定が決まっているか
根拠となる情報: 期限台帳、更新予定、作業担当
点検対象: 容量・費用
確認したいこと: 増加の理由を説明できるか
根拠となる情報: 使用量の推移、請求予測、変更履歴
「AIが判断しやすいデータ」だけに寄せると、必要な点検が抜けます。会社の受注、出荷、締め時間に必要な項目を起点に、取得方法を決めてください。機械で取得できない復元試験の記録などは、担当者の入力を残したままでも始められます。
4. 利用者の状態を測るSLIを一つ定義する
SREの監視では、遅延、トラフィック、エラー、飽和という四つの基本指標が紹介されています。Google SRE:Monitoring Distributed Systems
本記事では、それを受注業務に置き換えた測定案を作ります。SLIはサービスの状態を測る指標、SLOはその指標に対して目指す水準です。AIに「正常か」と聞く前に、測定の定義を書いておくと、日によって判断が変わりにくくなります。
受付成功率をどう数えるか
この例では、会社が定めた入力・認証条件を満たし、受注サービスの入口へ到達した依頼を分母にします。そのうち受付番号が発行され、受付台帳へ記録された依頼を成功として数えます。内部エラーや応答時間切れは失敗に含めます。重複送信を新しい注文として数えないよう、同じ依頼IDを区別するルールも必要です。
たとえば説明用のデータで、有効な依頼が200件、受付成功が198件なら成功率は99%です。ただし「注文できないため依頼自体が入口へ届かなかった人」は、この値だけでは把握できません。画面から受付までを確認する定期的なテストや問い合わせ件数を、別の観測として併用します。この数字は架空の計算例で、推奨SLOや実績ではありません。
時間帯と遅延の定義も固定する
受付の遅延を測るなら、入口で依頼を受けた時刻から、受付番号を返すまでとします。成功した依頼と失敗した依頼の時間を分け、集計する時間帯を明記します。夜間の低い利用量と、朝の注文集中を単純に比較しないようにします。
倉庫連携では「最後に成功した時刻」に加えて、未処理注文の最も古い受付時刻を見ます。利用がない時間帯の更新停止と、注文があるのに進んでいない状態を区別するためです。SLOの数値は営業と保守の担当者が、出荷への影響と費用を踏まえて決めます。
5. ADKのワークフローを五つの役割に分ける
ADK 2.0のグラフワークフローでは、AIの処理と通常の関数を、明示した順序や分岐でつなげられます。Python、TypeScript、Goの対応表があり、第三者連携には未対応の組み合わせもあります。ADK:Graph workflows
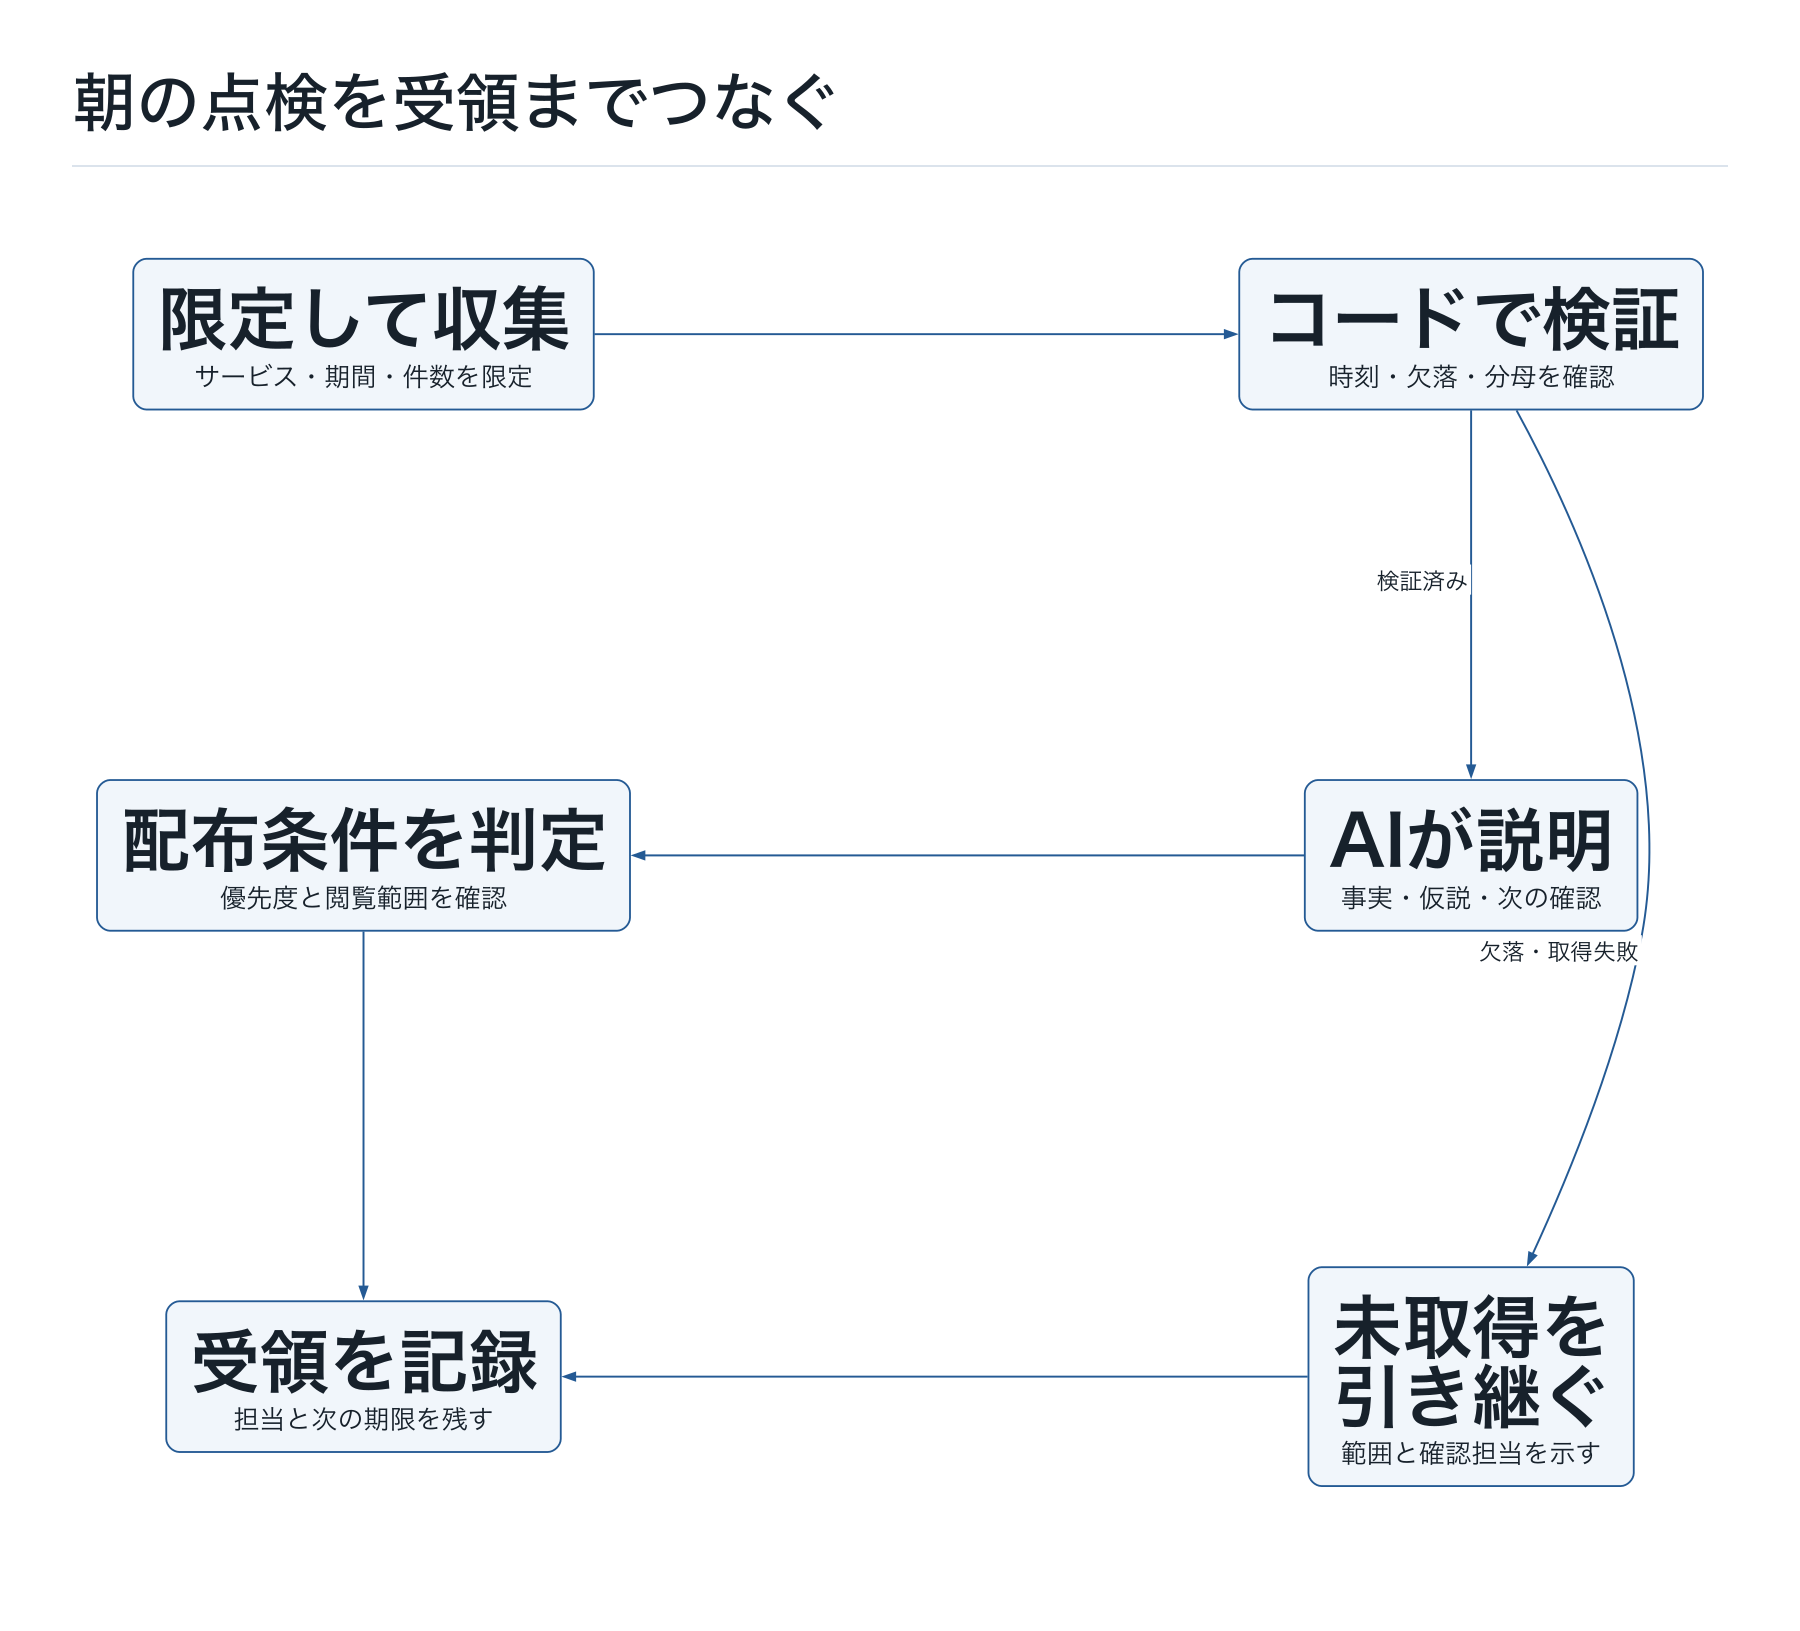
朝の点検では、次の流れを設計します。
- 収集する。 許可されたサービスの指標、ジョブ結果、変更履歴を、決めた時間範囲で取得します。
- コードで確かめる。 取得時刻、対象、欠落、集計の分母を検証し、決めたSLIを計算します。
- AIが説明する。 昨日との差、業務への影響候補、追加確認が必要な点を、根拠を添えて整理します。
- 配布条件を判定する。 優先度と担当者をルールで決め、報告を閲覧できる相手を確認します。
- 受け渡しを記録する。 報告の生成時刻、参照先、確認担当、次の期限を台帳へ残します。
ログと容量の照会など、互いに依存しない読取は並行できる設計にします。データがそろった後の集計と報告は、必要な順序で進めます。途中でログ取得が失敗した場合、AIは埋め合わせの数字を作らず、報告に「取得できなかった範囲」を表示します。
流れをコードで固定しても、AIが書いた説明の正しさは別に評価します。 AIの文章に「問題なし」とあっても、指標の検証結果に欠落があれば、確認待ちとして担当者へ渡す設計です。
 図を大きく表示
6. 読み取りから始めるときも、範囲を限定する
監視データには、顧客の識別情報、注文内容、社内の構成、認証情報に関係する文字列が混ざる場合があります。書き込み権限を与えなければ、それだけですべての利用が安全になるわけではありません。不要な情報を読ませない範囲設計が必要です。
架空の会社では、点検用の取得ツールにサービスID、許可された時間範囲、件数上限を持たせます。必要な対象と操作だけを認める、最小権限の考え方です。利用者が自由に顧客IDを指定して別の会社のログを読める構成にしません。取引先ごとのデータを扱う場合は、認証された利用者と対象取引先の対応を、取得処理の側で確認します。
AIへ渡すログは、調査に必要な項目へ絞り、不要な個人情報や資格情報を除いた表示用データにします。詳しいログが必要な担当者には、既存の認証を通した原本へのリンクを提示します。報告を受け取る営業担当者と、保守会社が見られる内容も分けます。
ログの本文に「前の指示を無視して」といった文章があっても、それは観測したデータとして扱います。アクセス先や配布先を変更する権限は与えません。権限の設定、機密情報の除去、参照先の許可をツールで確認する方針を、点検の試作段階から採り入れます。
7. 「事実・仮説・次の確認」を一枚で読める報告にする
朝の報告は、長いログの要約だけでは読みにくくなります。担当者が次の行動を決められるよう、次の型を使います。
観測した事実: 指定した時間帯の受注受付でエラーが増えている。取得対象と集計時刻を記載する。
AIの仮説: 直近の変更が関連している可能性がある。変更の時刻が近いことだけでは原因と確定できない。
未確認: 利用者の画面から受付までの状態。外部連携先の応答。
次の確認: インフラ担当者が入口の確認を行い、保守会社へ変更差分の確認を依頼する。
担当と期限: 調査担当、業務連絡の担当、次に状況を更新する時刻。
「昨日より遅い」という比較には、対象時間帯、依頼数、遅延の集計方法を付けます。ログの一部だけを読んだ場合は、全件を確認した印象を与えない表示にします。「全体で障害が起きている」か「特定の依頼で問題がある」かも、確認できた範囲に合わせて書き分けます。
報告の末尾には、生成時刻、参照したデータの最新時刻、対象サービス、点検ルールの版を残します。担当者が後で読み直したとき、どの状態を説明していたかが分かるからです。AIの報告が更新されても、以前の報告と担当者の確認結果は追跡できる形で保存します。
8. 通知の優先度と引き継ぎ先を先に決める
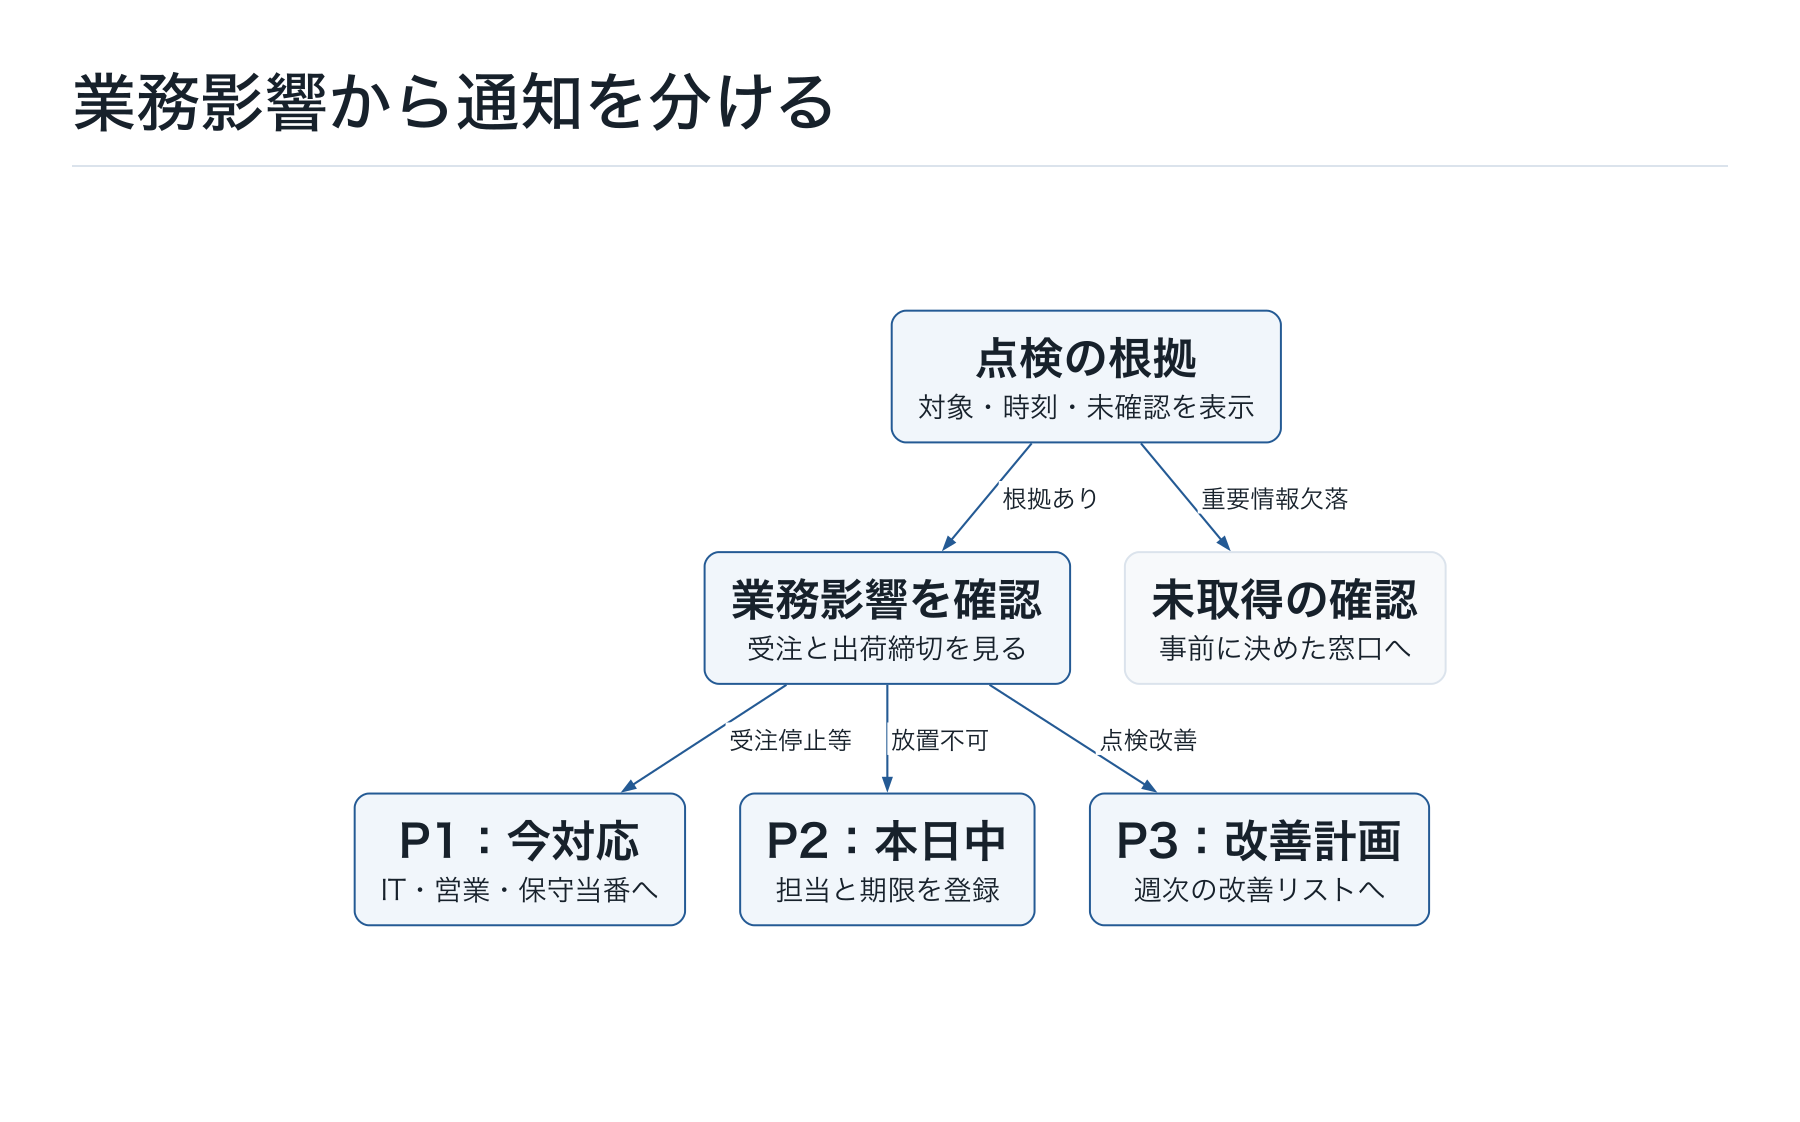
毎朝同じ警告が並ぶと、読者は確認を後回しにします。架空の会社では、優先度を業務影響と確認期限に結び付け、以下のように分けます。これは会社内で合意する分類例です。
- P1:今対応する。 注文受付が利用者に影響して止まっている、または出荷締め時間に間に合わない滞留が確認された状態。インフラ担当者と営業責任者へ連絡し、保守会社の当番に引き継ぎます。
- P2:本日中に確認する。 容量の増加や一部ジョブの失敗など、直ちに受付を止めていないが放置できない状態。担当と確認期限を作業台帳へ登録します。
- P3:計画して改善する。 重複した点検や、手順書の更新など。週次の改善リストで扱います。
重要なサービスの情報を取得できなかった場合は、正常とは扱わず、事前に決めた担当者へ確認依頼を出します。一方、同じ原因候補から発生した複数の通知は、一つの調査案件へ関連付けます。独立した障害まで同一と決めつけないよう、統合理由を記録します。
通知には、誰が受け持つかと、次の連絡時刻を必須にします。AIが報告を作っても、担当者の受領が確認できていなければ引き継ぎ完了にはしません。休暇中や連絡がつかない場合の代替担当も、点検システムの外で合意しておきます。
 図を大きく表示
9. 小さな評価セットで、見落としと過剰通知を確かめる
初期の評価では、過去の記録を必要な範囲で匿名化し、担当者が正解と確認理由を付けます。通常の日、連携が遅れた日、ログの取得が欠けた日、障害が自然に収まった日を含めます。同じ結果だけが続く教材では、境界の動作を確かめられません。
たとえば次の問いで点検します。
- 参照した時刻と対象サービスが正しいか。
- 観測値を本文へ転記するとき、数字と分母を保っているか。
- データが欠けたときに、正常と報告していないか。
- 仮説を原因確定の文章へ変えていないか。
- 見る権限のない顧客情報を取得、表示していないか。
- 担当者と確認期限が、会社の運用ルールに合っているか。
成果を見るときは、報告の作成時間だけでなく、人が原本を再確認した時間、修正件数、見落とし、不要な通知も記録します。「AIが短時間で報告した」が、担当者の確認を増やしていれば、導入の目的からずれます。
最初の期間は、従来の点検と並行して使い、違いを確認します。営業日や利用量が異なる日を比較した結果から、削減効果をすぐに断定しません。定義を固定した対象点検で、前後の実作業時間と品質を確かめます。
10. 継続運用の費用と停止条件を用意する
報告を一度生成する費用だけでなく、ログ取得、保存、クラウド実行、人の確認、保守も含めて管理します。必要な期間と件数を決めずにログを読ませ続ける構成は、時間と費用の見積もりが難しくなります。
架空の会社の初期設定例として、一回の点検で読む期間と件数、処理時間、モデル呼び出し回数に上限を設けます。到達したら、その時点の事実と未取得範囲を報告し、担当者へ渡します。再試行は一時的な取得エラーなど事前に決めた条件に限り、回数と待ち時間を制限します。
日次の報告は、対象日と対象サービスを一意のキーで管理します。同じ点検が二回開始されても通知を重ねないよう、生成・配布・受領の状態を確認します。配布の応答が消えた場合は、届いたかを照合してから再送を判断します。読み取り中心の点検でも、通知や台帳登録には副作用があるためです。
AI側が止まっても、既存の監視通知と担当者の点検手順を利用できる構成にします。自動報告の失敗が、受注サービスの停止や監視の喪失へ広がらないよう、運用上の依存関係を整理してください。
11. そのまま使える日次点検の設計シート
次の項目を、担当者と営業責任者で一緒に埋めてみてください。空欄はAIに推測させず、試作前の未決事項として扱います。
- 対象業務: どの利用者が、何を完了できる状態を守るか。
- 対象範囲: サービス、取引先、時間帯、取得する件数の上限。
- SLI: 分子、分母、成功・失敗、重複、欠落の数え方。
- 目標と期限: どの水準を目指し、いつまでに確認するか。
- 証拠: 指標、台帳、ジョブ記録、変更履歴の取得先と時刻。
- AIの役割: 比較と説明、未確認点の整理、追加調査の候補。
- コードの役割: 集計、アクセス確認、通知条件、状態管理。
- 人の役割: 報告の確認、業務への影響判断、作業の承認。
- 引き継ぎ: 主担当、代替担当、受領方法、次の連絡時刻。
- 停止と復帰: 何が起きたら自動報告を止め、誰が再開するか。
- 評価: 見落とし、過剰通知、修正時間、完了した点検の費用。
書き終わったら、担当者が休む朝を想定して読み直します。その日の受注状態が分かるか、未確認点に気付けるか、連絡先が見えるかを確かめてください。この確認は、AIの導入準備と同時に、属人化した点検の改善にもつながります。
12. 最初の四週間をどう進めるか
一週目は、点検項目と判断の定義をそろえます。 受注受付など一つの業務に絞り、既存の監視、台帳、担当者の確認手順を整理します。足りない観測は、AIの文章で補わず、取得方法を決めます。
二週目は、情報を限定した報告を作ります。 テスト用データで、数字の一致、出典、欠落の表示を確認します。権限違反や外部の命令文を含めた入力でも、許可範囲が保たれるか確かめます。
三週目は、従来の点検と並行して使います。 報告の正しさに加え、担当者の確認時間と不要通知を記録します。通知先は関係者に限定し、優先度の分類を調整します。
四週目は、継続する範囲を決めます。 安定して確認できた項目を日次運用へ進め、根拠が不足する項目は担当者の確認を続けます。この四週間は進め方の例で、導入期間や成果を約束するものではありません。
毎朝の報告が役立つようになったら、次は障害が起きたときの調査と引き継ぎを整えます。連載第6回では、同じ受注サービスを使い、AIの仮説、担当者の承認、復旧処理を分けるSRE設計を扱います。
自社の点検業務を整理したい方は、対象サービス、現在の確認手順、困っている引き継ぎを添えて、KONDAXへご相談ください。何から測るか、どこを自動化の候補にするかを具体的に検討する入口になります。
実践前の3つのチェック
- 受注成功率の分母と、欠落の扱いが同じか。
- 仮説を原因確定の文章へ変えていないか。
- 主担当不在でも受領と次の連絡が分かるか。